terraformでファイルのハッシュを確認するメモ(ついでにnull_resourceについて)
概要
- terraformのLambda layer等を作成するときに、ファイル更新を検知したい
詳細
archive_file
よくある手法が、Data sourceであるarchive_fileを利用する方法
data "archive_file" "main" {
  type        = "zip"
  source_dir  = "${path.module}/${var.dir_name}/hogehoge"
  output_path = "${path.module}/${var.dir_name}/fuga/layer.zip"
}
このように、zipファイルを特定のディレクトリをもとに作ってくれる機能。
resource "aws_lambda_layer_version" "lambda_layer" {
  layer_name       = "layer-name"
  filename         = data.archive_file.main.output_path
  source_code_hash = data.archive_file.main.output_base64sha256

  skip_destroy = false
}
このようにdata.archive_file.main.output_base64sha256といった感じでZipのbase64sha256が取得でき、Zipファイルの変更を検知してくれる
直接ファイルのsha256を参照する
filebase64sha256を利用する
archive_fileを使わずに、直接sha256を参照することも可能。
あまりないかもしれないが、ローカルの特定のパスにZipファイルが存在することがわかっている場合等に有効と思われる
filebase64sha256("/path/to/file")
resource "aws_lambda_layer_version" "lambda_layer" {
  layer_name       = "layer-name"
  filename         = data.archive_file.main.output_path
  source_code_hash = filebase64sha256("/path/to/file")

  skip_destroy = false
}
このように、直接ファイルのbase64sha256を取得可能
ちなみに、base64sha256という関数もあり、これは引数に渡された文字列のbase64sha256を取るということっぽいので間違えないように。
これのせいで結構ハマった。
Lambda layerに限ったメモ
Lambda layerを前述のようなZipファイルから作成するのは定番の手法と思われるが、
10MB以上のファイルになるとエラーが出てしまうことがある。
S3を利用してのアップロードを検討する必要がある
クラスメソッドさんの記事でも紹介されている
null_resourceを利用してZipを作ってそれをs3にコピーする技
resource "null_resource" "copy_to_s3" {
  triggers = {
    "code_diff" = join("",
      [
        filebase64("/path/to/my-source"),
        filebase64("/path/to/build-lambda.sh"),
      ]
    )
  }

  provisioner "local-exec" {
    command = "/bin/bash /path/to/build-lambda.sh"
  }

  provisioner "local-exec" {
    command = "aws s3 cp /path/to/outputs/layer.zip s3://${var.bucket_path}"
  }
}
このように、特定のファイルに変更が入ったことを検知して任意のコマンドを実行することが可能
上記の例だと、
"/path/to/my-source", "/path/to/build-lambda.sh"に変更がないことをnull_resourceが確認し、変更があったときにlocal-execで指定されたコマンドを実行することとなる
"/bin/bash /path/to/build-lambda.sh"で何かしらのZipファイルを作って、
作成したZipファイルを"aws s3 cp /path/to/outputs/layer.zip s3://${var.bucket_path}"でS3のバケットにコピーするようなイメージ
awkメモ(ifとかgsubとか)
概要
詳細
aws s3 ls
aws s3 ls --recursiveをすると、以下のようなテキストが取れる
2023-04-28 15:51:30       6592 path/to/file/file1.jpg
2023-04-28 15:51:30      12042 path/to/file/file2.jpeg
2023-04-28 15:51:30      60251 path/to/file/file3.png
2023-04-28 15:51:30       7176 path/to/file/file4.jpg
2023-04-28 15:51:30       7176 path/to/file/file5.htlm
2023-04-28 15:51:30       7176 path/to/file/file6.jpg
これがファイルになっていると仮定
aws s3 ls s3://bucket-name/path/to/target/directory/ --recursive --profile my-profile > s3.txt
awkで抽出
cat s3.txt | awk '{ if (match($4, /^path\/to\/file\/.*(\.jpg|\.png)/)) { gsub(/^path\/to\/file\//, "", $4); print "./"$4 } }'
./file1.jpg
./file3.png
./file4.jpg
./file6.jpg
解説
awk '{ if (match($4, /^path\/to\/file\/.*(\.jpg|\.png)/))
これが$4つまり4つ目のカラムから抜き出して、正規表現matchで特定のパターンが存在するかどうかを判定するif文
{ gsub(/^path\/to\/file\//, "", $4);
こちらが、gsubで文字列の置換をしている部分。
先頭のpath/to/file/の部分を削除している
print "./"$4
最後に先頭に./を追記してプリントしている
Cognito+Lambda@EdgeでCloudFrontの配信コンテンツに認証をつける
概要
- Cognito+Lambda@Edgeをつかって、CF配信に認証をつけたい
cognito-at-edgeを使用する- ものすごいハマってしまったので、将来の自分の為に残す
とても参考にさせていただきました
CF作成
配信はCF+S3で実施する。
S3作成
- S3バケットを作成(リージョンは東京で作った)
CF作成
- CF作成し、オリジンをS3指定する
- OriginAccessControlで制御する

- S3バケットにアクセス制御を記載する
{
    "Version": "2008-10-17",
    "Id": "PolicyForCloudFrontPrivateContent",
    "Statement": [
        {
            "Sid": "AllowCloudFrontServicePrincipal",
            "Effect": "Allow",
            "Principal": {
                "Service": "cloudfront.amazonaws.com"
            },
            "Action": "s3:GetObject",
            "Resource": "arn:aws:s3:::gamecontainer-ot-content/*",
            "Condition": {
                "StringEquals": {
                    "AWS:SourceArn": "arn:aws:cloudfront::012345678901:distribution/XXXXXXXXXX"
                }
            }
        }
    ]
}
これでS3➡CFのアクセスができるようになる。
CFのディストリビューション名でアクセスをして確認してみると良い
Lambda@Edgeを作成
こちらのライブラリをそのまま使う
npm init
npm install cognito-at-edge
npm install dotenv
一応dotenvと組み合わせたけど、これは本質ではない。本来ならSecretManager使うとか、環境変数に入れるとかするべきかも。
require('dotenv').config();

const { Authenticator } = require('cognito-at-edge');

const authenticator = new Authenticator({
  // Replace these parameter values with those of your own environment
  region: process.env.REGION, // user pool region
  userPoolId: process.env.USERPOOLID, // user pool ID
  userPoolAppId: process.env.USERPOOLAPPID, // user pool app client ID
  userPoolDomain: process.env.USERPOOLDOMAIN, // user pool domain
});

exports.handler = async (request) => authenticator.handle(request);
Cognito作成
Cognitoは今回はメールアドレスとパスワードの認証で作成。
これは任意でOKのはず。最初はお試しでメールパスワードの認証がわかりやすい。
アプリクライアントの確認
デフォルトでアプリクライアントが作成されているはず

これのWebと名前書いたやつを使おう。(どっちでもいけるのか?)
アプリクライアントの設定
ここが本番。

以下を設定する
- コールバックURL
- 先ほど作ったCFのディストリビューションドメインを指定する(Route53で別ドメインとか設定するならそちらのドメインになるはず)
- つまり、Cognitoでログインした後にどこにアクセスさせることを許可するの?って設定
- Authorization code grand
- openid
このAuthorization code grandとopenidをチェック忘れていてひどくハマった・・・
L@Eの設定
Lambda@Edgeに記載する情報がそろったので、.envを記載する
.envを用意する
REGION=ap-northeast-1
USERPOOLID=ap-northeast-1_hogehoge
USERPOOLAPPID=userpoolappid
USERPOOLDOMAIN=domain.auth.ap-northeast-1.amazoncognito.com
Lambdaは必ずバージニア北部で作成する必要があります(Lambda@Edgeとして登録する際の条件)
以下、Lambdaをデプロイするときのコマンド例
zip -r function.zip .env index.js package-lock.json package.json node_modules
aws lambda update-function-code --function-name function-name --zip-file fileb://function.zip --region us-east-1 --profile myprofile
- USERPOOLID
- Cognitoのユーザプールの名前。似たような名前が記載されているはず
- USERPOOLAPPID
- これがさっきのアプリクライアントID USERPOOLDOMAIN
- Cognitoの認証エンドポイントを独自にドメインを決められるので、その名前。
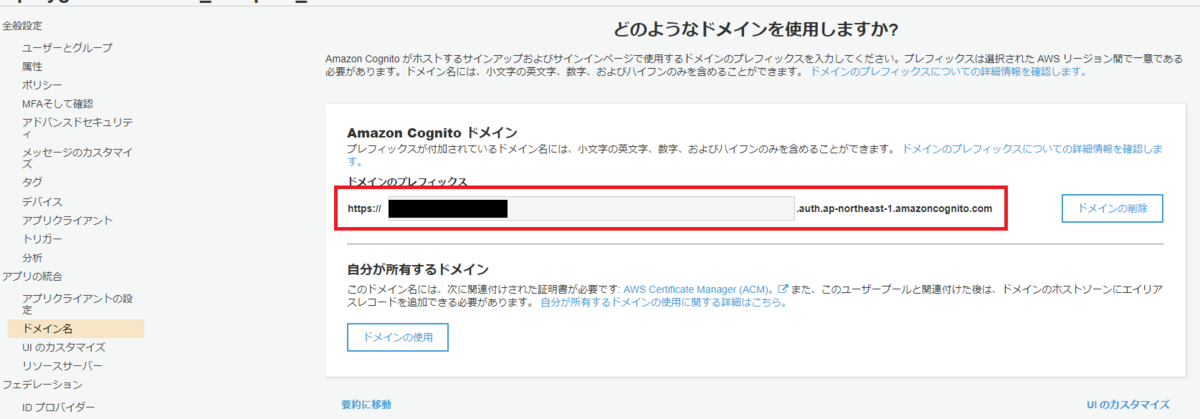
👆で設定できる。Cognitoのドメインのものを使う場合は早い者勝ちになる。
Lambda@Edgeの設定
- Lambda@EdgeはCFのビューワリクエストに張り付ける
- ちなみに、ビューワリクエストにLambda@Edgeを貼るということは、リクエストが呼ばれるたびにLambda@Edgeが動くことになる。お金の心配したくなる
- オリジンリクエストにはったLambda@Edgeは、レスポンスをCFがキャッシュしてくれるときには呼ばれない
- キャッシュをしっかり効かせてやると、静的ページであればほとんどLambda@Edge呼ばれないっていう感じになるはず
Lmabda@Edgeの設定

Lambdaの画面から、「バージョン」を選択し、「新しいバージョンを発行」を実施して、新バージョンを作る

「トリガを追加」からCF選ぶ
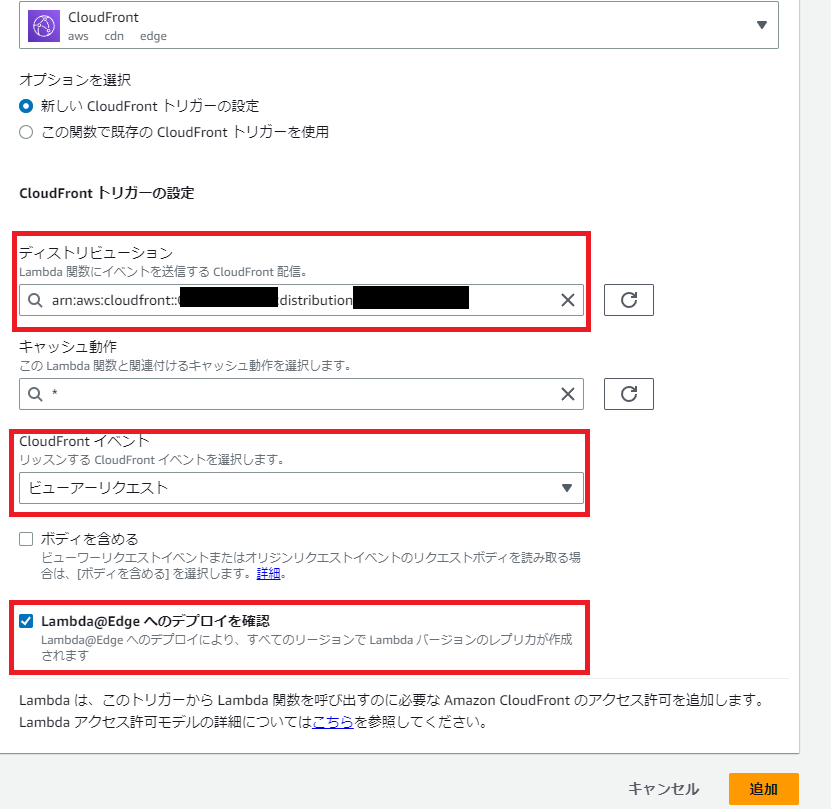
- ディストリビューションを選ぶ
- CloudFrontイベントは「ビューアーリクエスト」を選ぶ
Lambda@Edgeへのデプロイを確認をチェックする(これチェックしないとデプロイできない)
確認
CFのデプロイはおそらく5分くらいで終わるので、デプロイ後にCFのディストリビューション名称でアクセスして確認する
Cognitoのログイン画面が出てきて、ログイン求められるはず。作ったユーザでログインできればOK
aws-sdk と @aws-sdk
aws-sdk と @aws-sdk について
v2 と v3の違いらしい
新しいものを作るときにはv3@aws-sdkのほうを採用するほうがいいでしょう
コードの差
dynamoDBの例
参考
What's the AWS SDK for JavaScript? - AWS SDK for JavaScript
v2
var AWS = require("aws-sdk");
// Set the Region
AWS.config.update({region: "us-west-2"});
// Create DynamoDB service object
var ddb = new AWS.DynamoDB({apiVersion: "2006-03-01"});

// Call DynamoDB to retrieve the list of tables
ddb.listTables({Limit:10}, function(err, data) {
  if (err) {
    console.log("Error", err.code);
  } else {
    console.log("Tables names are ", data.TableNames);
  }
});
v3
import { DynamoDBClient,
           ListTablesCommand
   } from "@aws-sdk/client-dynamodb";
(async function () {
   const dbclient = new DynamoDBClient({ region: 'us-west-2'});

  try {
    const results = await dbclient.send(new ListTablesCommand);
    results.Tables.forEach(function (item, index) {
      console.log(item.Name);
    });
  } catch (err) {
    console.error(err)
  }
})();
v3 おまけ (dynamoDBでアトミックカウンタ)
import {
  DynamoDBClient,
  UpdateItemCommand,
  DynamoDBClientConfig,
} from '@aws-sdk/client-dynamodb';

const config: DynamoDBClientConfig = {
  region: 'ap-northeast-1',
};

const dynamo = new DynamoDBClient(config);

(async function () {
  try {
    const output = await dynamo.send(
      new UpdateItemCommand({
        TableName: 'my-table',
        ReturnValues: 'ALL_NEW',
        Key: {
          result: { S: 'one-status' },
        },
        UpdateExpression: 'ADD #count :incr',
        ExpressionAttributeNames: {
          '#count': 'count',
        },
        ExpressionAttributeValues: {
          ':incr': { N: '1' },
        },
      })
    );
  } catch (err) {
    console.error(err);
  }
})();
上記の例は、my-tableのresultというKeyがone-statusという値になっているレコードに対し、countというカラムをインクリメントするという例
参考
dynamoDB dev.classmethod.jp maku.blog
TerraformでAWSマルチリージョンでリソースを作成する
概要
- terraformを利用し、AWSマルチリージョンでリソースを作成したい
- 別リージョンでmoduleを作成したい
このあたり、必要になるたびにググっているので備忘録として。
AWSリージョンの定義
provider "aws" {
  profile = "default"
  region  = "ap-northeast-1"
}

provider "aws" {
  profile = "default"
  region  = "us-east-1"
  alias   = "virginia"
}
このように、マルチリージョンごとに定義を記載する
data, resource等を別リージョンで宣言する場合
providerを記載してやればOK
data "aws_acm_certificate" "virginia" {
  domain   = "domain.name"
  provider = aws.virginia
}
moduleを別リージョンで宣言する場合
こちらもprovidersを記載してやる
module "my_module" {
  source = "./path/to/module"

  hoge = "fuga"

  providers = {
    aws = aws.virginia
  }
}
さらにmoduleにrequired_providersを記載してやる
terraform {
  required_providers {
    aws = {
      source  = "hashicorp/aws"
      version = "~> 3.27"
    }
  }
}
上記記載をmodule内のどこかのファイルに記載してやればOK
amplify initのエラー対応(Cannot redefine property: default)
めちゃくちゃハマったので未来の自分の為にメモ
環境
windows WSL2
amplify -v
10.5.2
概要
- amplify initのときにエラーがでる
Cannot redefine property: default

結論
~/.aws/configが変な書式になっていた(defaultプロファイルの記載がおかしかった)
[profile default]
region=ap-northeast-1
output=json

[default]
region=ap-northeast-1
output=json
このようにdefaultが[profile default]として記載があるのはおかしいようで。
[default]
region=ap-northeast-1
output=json
このように、[default]のみが存在するように編集すればOK
参考
こちらのGitHubのコメントが決めてでした。
ありがとう!
GCPのインストール+GKEへの接続
概要
- gcloudコマンドを使えるようになるまで
- gcloudコマンドを使ってGKEに接続できるようになるまで
環境
- Win10 Pro
- WSL2 Ubuntu 20.04
gcloudコマンドを使えるようになるまで
今までGCPをそもそもほとんど触ったことがなく、さらにCLIからGCPを操作したことがありませんでした。 ついにやる機会が来たのでやってみましたが、すごい大変だったので、メモを残します
gcloudインストールまでの道のり
- python3.8をインストールする
- 3.8じゃないといけないのかわからないが、3.9をイキって入れたら動かなかった
- asdfで入れたかったけど無理だったから普通にaptで入れた
- python3のパスじゃダメなので、pythonのパスを通す
- gcloudをインストールする
- イキってasdfで入れたかったけど無理だったから普通に入れた
1. python3.8インストール
sudo add-apt-repository ppa:deadsnakes/ppa
sudo apt update
sudo apt install python3.8
2. python3のパスじゃダメなので、pythonのパスを通す
zsh使っているので、~/.zshrcに以下を追加
# alias
alias python='python3'
3. gcloudをインストールする
- 公式を読みました
signed-by オプションとか、--keyringとか聞いたことなかった
sudo apt-get install apt-transport-https ca-certificates gnupg

# signed-by
echo "deb [signed-by=/usr/share/keyrings/cloud.google.gpg] https://packages.cloud.google.com/apt cloud-sdk main" | sudo tee -a /etc/apt/sources.list.d/google-cloud-sdk.list

# --keying
curl https://packages.cloud.google.com/apt/doc/apt-key.gpg | sudo apt-key --keyring /usr/share/keyrings/cloud.google.gpg add -

# install
sudo apt-get update && sudo apt-get install google-cloud-sdk
これでgcloudのインストールは完了
gcloudコマンドを使ってGKEに接続できるようになるまで
gcloudコマンドでのログイン
gcloudのCLIからGCPに対してアクセスができるように認証をする必要があります。
aws configure的なやつです。
方法は2種類あるようで、
gcloud auth login
gcloud init
のどちらかっぽいですが、gcloud auth loginで実施しました。
gcloud auth login実施すると、CLI上にGCPのログイン用のURLが表示されるので、そのURLをクリックしブラウザでログインします(目当てのアカウントでログイン)
ログインしたらなんかハッシュキーみたいなのが表示されるんで、それをCLI上にコピペしてDoneです。
gcloudのプロファイルの確認
AWSでいうところのaws sts get-caller-identity的なのがやりたくて。
それは以下
$ gcloud auth list
     Credentialed Accounts
ACTIVE  ACCOUNT
*       hogehoge@example.com

To set the active account, run:
    $ gcloud config set account `ACCOUNT`
こんな風に出ます。
どうやらアカウントを切り替えるには$ gcloud config set account ACCOUNTってやるようですね
GKEへの接続
※GKEへ接続する際、もしかしたらpluginのインストールが必要って言われます
$ gke-gcloud-auth-plugin --version
これでバージョンが正しく出力されたらいいらしいですが、出なかったらインストール。
$ gcloud components install gke-gcloud-auth-plugin
GKEへ接続しますが、まずはGKEのクラスタ一覧を表示
$ gcloud container clusters list --project my-project
NAME               LOCATION           MASTER_VERSION   MASTER_IP       MACHINE_TYPE   NODE_VERSION     NUM_NODES  STATUS
my-cluster        asia-northeast1-a  ~~~
みたいなのが出ます。my-clusterへつなぎたい。
$ gcloud container clusters get-credentials my-cluster --zone=asia-northeast1-a --project my-project
これがうまくいけば、ローカルの~/.kube/configにクレデンシャルが記載されて接続が可能に。
以下はkubectlを使ってアクセスです
$ kubectl config get-contexts
これで想定のクラスタ(my-cluster)が表示されていればOK
